A tecnologia mantém empresas em funcionamento. Porém, basta um click errado, uma queda de energia ou uma forte chuva para colocar tudo em risco. Cancelas não sobem, pedidos não chegam, sistemas param.
Quando falamos em contingências, não é exagero pensar que, sem um plano de recuperação de desastres, os prejuízos podem ser enormes. Empresas como a Keppel Consultoria em TI reconhecem a necessidade de um preparo. Mas afinal, o que é, de fato, um plano de Disaster Recovery, e como conduzir um processo capaz de restaurar as operações de TI com eficiência?
Neste artigo, vamos mostrar como o planejamento é o segredo para atravessar desastres, sejam eles naturais, técnicos ou causados por ataques, minimizando perdas e fortalecendo a continuidade dos negócios.
O que é plano de recuperação de desastres em TI
Todo sistema de TI pode falhar, por mais avançada que seja a tecnologia. O plano de recuperação de desastres (ou simplesmente Disaster Recovery) é uma estratégia formal e estruturada para restaurar o funcionamento da infraestrutura de TI após eventos graves, prevendo procedimentos, responsabilidades, prazos e recursos para restaurar dados, sistemas, equipamentos e serviços essenciais.
Um bom plano nunca é uma simples cópia de segurança. Ele vai além do backup de rotina, envolve análise de riscos, determinação dos ativos mais críticos, escolhas tecnológicas, automações e treinamento de pessoas. Não existe um padrão universal; cada empresa precisa de um plano compatível com seu nível de maturidade, orçamento, regulamentações e realidade de negócios.
Planejar é antecipar o que ninguém espera acontecer.
É sobre estar pronto antes que o inesperado bata à porta. Sem esse preparo, as consequências podem ser duras.
- Perda de receitas
- Interrupções prolongadas nos serviços
- Quebra de contratos
- Danos à imagem institucional
- Multas e sanções legais
Por essas razões, companhias do porte da Keppel Consultoria em TI têm investido na consolidação do conceito Disaster Recovery com cada vez mais seriedade.
Por que o Disaster Recovery é tão relevante?
O mundo digital tornou a dependência da tecnologia inevitável. Mesmo microempresas hoje contam com ERPs, sistemas de e-mail, ferramentas colaborativas, sites e sistemas de atendimento ao cliente. Uma pane não é apenas um problema operacional, pode ser uma ameaça existencial.
Veja alguns dos riscos mais recorrentes:
- Desastres naturais: enchentes, incêndios, tempestades e raios
- Falhas humanas: exclusão acidental de dados, má configuração de sistemas
- Falhas técnicas: defeitos em hardware, bugs de software, quedas de energia
- Ataques cibernéticos: ransomware, invasões, vazamento de informações
Mesmo um problema localizado, como a pane em um switch de rede ou o travamento de um servidor de arquivos, pode paralisar setores inteiros. Por isso, investir em medidas de contingência vai muito além de apenas segurança, envolve economia direta, confiança e até mesmo sobrevivência do negócio.
Recuperação rápida reduz impactos e garante operações estáveis.
Como funciona um plano de recuperação de desastres
O planejamento é meticuloso, mas não precisa ser complicado. Vamos simplificar: o objetivo é minimizar o tempo e a perda de dados entre a falha e a recuperação.
Para isso, dois conceitos precisam ficar claros: RTO e RPO.
Parece simples, mas encontrar o equilíbrio entre estes dois indicadores pode ser o grande desafio. Maior exigência, maior custo. Porém, compromissos bem definidos ajudam a escolher a tecnologia certa e a desenhar procedimentos eficazes.
Etapas do planejamento de Disaster Recovery
Criar um plano robusto é como construir um prédio. Começa no alicerce: levantamento de riscos, conhecimento da infraestrutura, e definição dos serviços críticos.
- Mapeamento dos ativos de TI Liste servidores, bancos de dados, aplicações, dispositivos de rede e pontos de conexão físicos e virtuais.
- Análise de impacto nos negócios Avalie o quanto cada serviço representa no faturamento, em contratos e produtividade.
- Identificação de riscos Considere ameaças naturais, técnicas, humanas e virtuais. Improvise. Pense além dos cenários óbvios.
- Definição de RTO e RPO Determine para cada sistema ou conjunto de dados o tempo máximo de parada e o limite de perda de informações aceitável.
- Desenho dos procedimentos de recuperação Escreva passo a passo quem faz o quê, em qual ordem priorizar sistemas, onde buscar dados e como comunicar clientes e equipes.
- Seleção de tecnologias e recursos Escolha métodos de backup, replicação, failover, formas de acesso remoto, automações e documentações complementares.
- Treinamentos e testes práticos Treine a equipe, simule desastres, teste restaurar backups e documente resultados.
Esse roteiro pode variar. Mas, em linhas gerais, é dele que nasce a capacidade da empresa de enfrentar crises sem pânico.
Métricas: como aplicar RTO e RPO no dia a dia
Após identificar RTO e RPO, é preciso aplicá-los de verdade. Não adianta definir que o RPO do banco de dados é de 5 minutos se, na prática, o backup ocorre todo fim de tarde.
- Automatize rotinas de backup e replicação: garanta que os ciclos sejam compatíveis com o RPO.
- Sincronize infraestruturas de apoio: mantenha servidores de redundância ou armazenamento secundário prontos para uso.
- Teste restaurar sistemas no tempo do RTO: é comum a simulação mostrar gargalos não previstos.
- Monitore indicadores: alertas de falha, atraso ou lentidão nos processos de cópia devem ser automáticos.
Exemplo prático: um servidor que guarda contratos críticos tem um RTO de 1 hora e um RPO de 10 minutos. Isso exige backups incrementais a cada 10 minutos e um ambiente alternativo pronto para assumir em até 60 minutos.
Se não testa, não funciona. Confie, mas confira.
Principais métodos e tecnologias envolvidas
Não existe Disaster Recovery robusto sem tecnologia bem escolhida. Ou, como se diz nos bastidores da TI, “o que salva é o que funciona de verdade”.
Hoje temos um leque amplo de soluções, cada uma com suas particularidades:
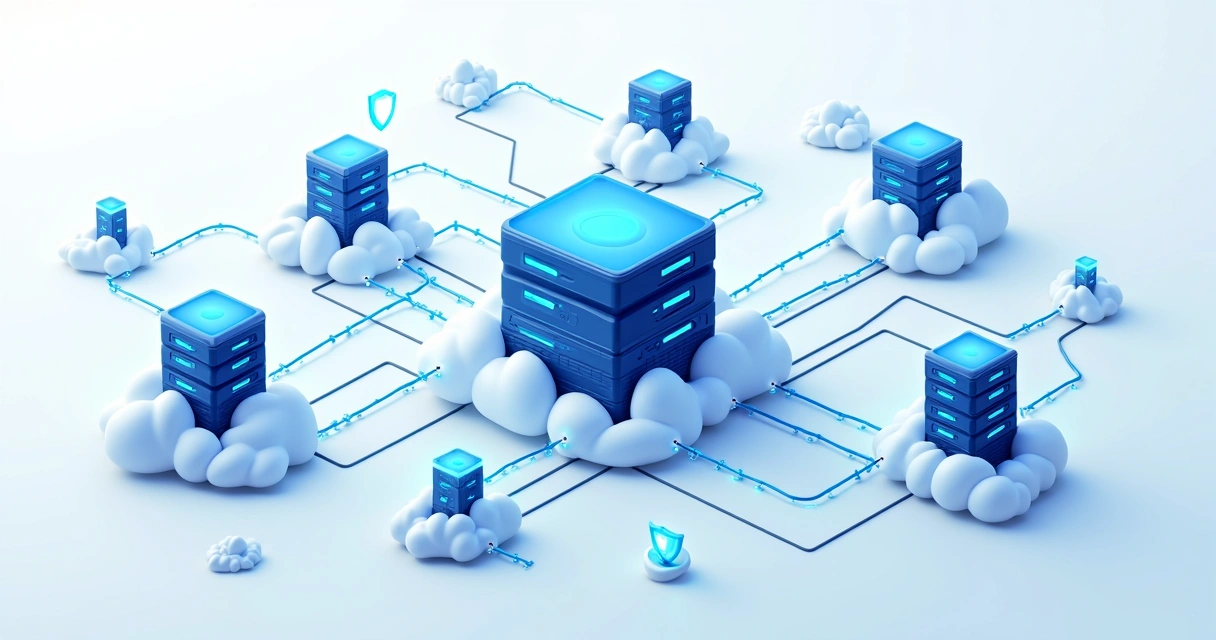
- Backups automáticos: Ferramenta clássica, cada vez mais sincronizada e com verificações automáticas de integridade. Pode ser feito em disco (local), fita (ainda útil para longos arquivamentos), nuvem,(Storage as a Service) ou estratégias combinadas.
- Replicação de dados: Espelhamento de dados entre ambientes distintos. Pode ser síncrona (em tempo real) ou assíncrona (com pequeno atraso), servindo para subir sistemas críticos quase sem perda de dados.
- Failover e clusters de alta disponibilidade: Permitem que, ao detectar uma falha, outro servidor assuma as funções praticamente sem perceção por parte do usuário.
- Soluções baseadas em nuvem: Serviços de cloud computing permitem restaurar ambientes inteiros, inclusive com automação do provisionamento de máquinas virtuais, redes e serviços complementares. A nuvem híbrida mistura infraestrutura local e cloud, enquanto a privada traz ambientes dedicados e isolados.
- DRaaS (Disaster Recovery as a Service): O plano de recuperação é entregue como serviço, no qual parceiros técnicos gerenciam a replicação, o armazenamento dos dados e, em caso de desastre, acionam ativações automáticas do ambiente de contingência.
Entre exemplos de soluções automatizadas, destacam-se recursos como automação de failover, scripts inteligentes de restauração, gateways de backup em nuvem, e plataformas que coordenam múltiplos sites (multi-site failover).
Soluções modernas e tendências
A tecnologia evolui, e com ela, mudam os riscos. Os recursos considerados tecnologia de ponta há alguns anos já passaram a ser básicos. Hoje, vemos:
- Serviços de nuvem híbrida e privada: combinam flexibilidade, controle e segurança, moldando ambientes on-premises ao lado de clouds públicas.
- Automação de testes e recuperação: testes periódicos de recuperação sem interromper o ambiente de produção. Reconfiguração automática de políticas, scripts que simulam desastres, relatórios detalhados.
- Plataformas integradoras: integração de diferentes soluções, de máquinas legadas a novos sistemas, evitando ilhas tecnológicas e facilitando respostas rápidas.
- Soluções específicas: empresas de infraestrutura avançada oferecem funcionalidades como AWS Elastic Disaster Recovery, Azure Site Recovery, Google Cloud Backup and DR, e equivalentes. Isso permite replicar workloads quase em tempo real.
- Monitoramento por inteligência artificial: alertas automáticos, correção proativa de erros, sugerindo ações antes mesmo da falha acontecer.
Infraestrutura de TI para suportar contingências
A base do plano está nos equipamentos e sistemas. Se a infraestrutura não foi preparada para suportar picos de acesso, replicações rápidas e restauração simultânea de vários sistemas, todo plano fica só no papel.
Alguns pontos que fazem diferença na vida real:
- Links de comunicação redundantes
- Fontes de energia ininterruptas e geradores
- Firewalls e sistemas de detecção de intrusão adaptáveis
- Servidores virtualizados com snapshots rápidos
- Armazenamento em rede, incluindo SAN e NAS
Em times menores ou empresas com ambiente enxuto, vale contar com apoio externo, como a Keppel Consultoria em TI faz para seus clientes, projetando desde soluções focadas até ambientes híbridos e escaláveis.
Resiliência depende de tecnologia, processo e pessoas.
Testes, treinamentos e atualização dos planos
Plano parado não serve para emergência. Assim como extintor de incêndio vencido ou backup armazenado em mídia danificada.
O segredo está na cultura:
- Testar ao menos uma vez por semestre todos os procedimentos
- Simular cenários realistas (apagão, vírus, queda de link, incêndio)
- Ensinar equipes técnicas e operacionais: todos precisam saber o que fazer
- Atualizar contatos de emergência, checklists e documentações
- Revisar parâmetros: conforme o negócio cresce, RTO e RPO podem mudar
O que aprendemos com simulações
Quase sempre, na primeira simulação, aparecem falhas: scripts obsoletos, acessos bloqueados, falta de clareza de quem aciona o quê. Tudo isso pode ser contornado na medida em que o plano vira rotina, e todas as partes envolvidas entendem seus papéis.
Nos projetos acompanhados pela Keppel Consultoria em TI, empresas relataram melhoras claras na confiança dos times após simularem desastres reais, com avaliações periódicas baseadas em incidentes globais e aprendizados do mercado.
Cenários de desastres e como o planejamento faz a diferença
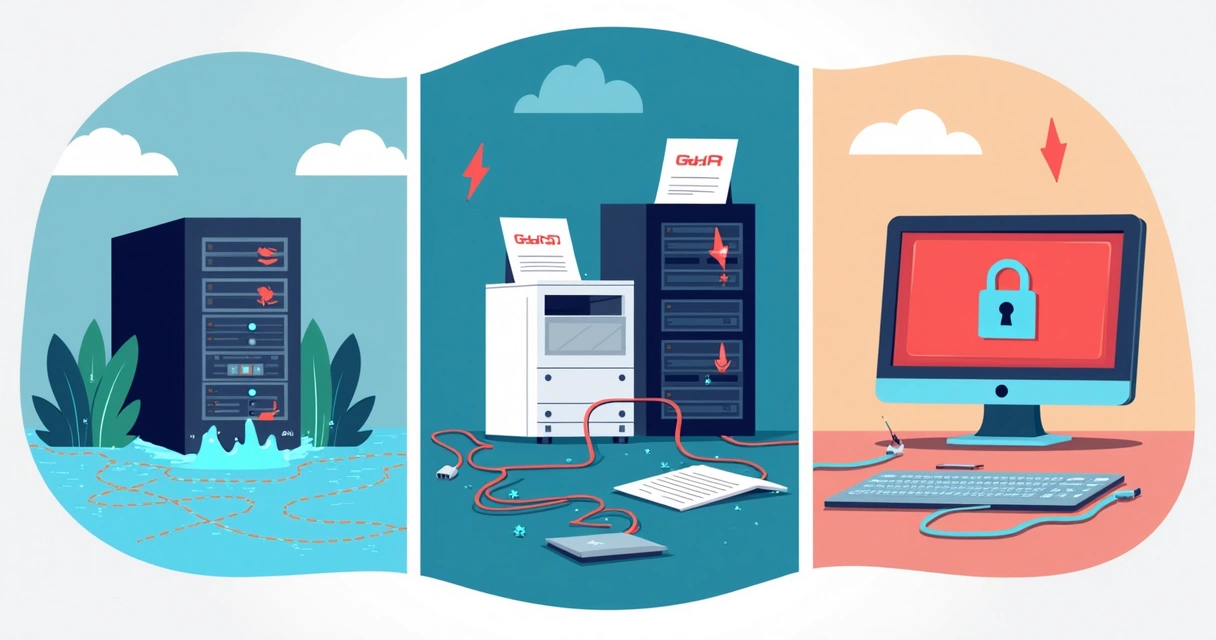
Cada empresa é única, mas os desafios se repetem. Três cenários emblemáticos ilustram o papel do plano de recuperação:
- Desastres naturais: Imagine uma chuva forte em Belo Horizonte causando enchente no servidor físico da empresa. Sem plano, dados podem ser perdidos de forma irrecuperável. Com réplicas em nuvem, é possível restaurar dados de horas antes.
- Falhas técnicas: Um colaborador acidentalmente deleta a base de clientes. Se backups automáticos estão em dia, a restauração ocorre em minutos, respeitando o RPO definido.
- Ataques cibernéticos: Um ransomware criptografa arquivos do setor financeiro. Com estratégias de isolamento e backups offline, é possível retornar ao último ponto estável sem sucumbir ao ataque.
Automação e recuperação inteligente
A automação virou aliada estratégica. Restaurações automáticas, notificação inteligente ao staff e acionamento de scripts prontos diminuem a dependência de profissionais e aceleram a resposta. Já existem sistemas que executam failover, checam integridade dos dados e até disparam comunicações de crise para clientes e times, tudo sem intervenção manual.
Empresas parceiras da Keppel Consultoria em TI relatam uma sensível queda no tempo de interrupção e nos incidentes não previstos graças à automatização de processos, que reduzem o erro humano e exigem menos recursos físicos.
Benefícios de um Disaster Recovery estruturado
Os efeitos positivos vão muito além de evitar prejuízos. Veja alguns benefícios práticos sentidos por negócios que investem em medidas consistentes:
- Evita perdas de receita por paradas de sistemas
- Minimiza impactos à imagem pública da empresa
- Atende exigências legais e regulatórias
- Permite recuperação ágil frente a ransomware e outros ataques
- Traz previsibilidade de custos
- Facilita auditorias e certificações
- Gera confiança entre clientes e parceiros
- Encoraja cultura preventiva e colaborativa no time
Além disso, soluções sob medida, inclusive para ambientes multitenant, multicloud, e altamente distribuídos, são adaptáveis a empresas de qualquer porte. O segredo está em não adiar o planejamento.
Conclusão
Ninguém quer passar por um desastre de TI. Porém, quem se prepara, raramente transforma uma crise em tragédia. O processo começa com perguntas simples, mas fundamentais: O que não podemos perder? Por quanto tempo podemos parar? Quem é responsável por acionar o plano?
Escolher as tecnologias, definir métricas claras, testar e manter tudo atualizado são responsabilidades que não podem mais ser ignoradas em um mundo digital tão volátil. A Keppel Consultoria em TI pode ser sua parceira para criar planos, automatizar rotinas e formar equipes resilientes. Assim, sua empresa ganha tranquilidade para crescer sem medo do imprevisível.
O melhor plano de recuperação é aquele pronto antes do problema chegar.
Fale com a equipe da Keppel Consultoria em TI para entender como proteger seu negócio com soluções sob medida, seja para pequenas adaptações ou projetos completos. Segurança, continuidade e adaptação estão a um convite de distância.
Perguntas frequentes
O que é recuperação de desastres em TI?
Recuperação de desastres em TI é o conjunto de estratégias, procedimentos e tecnologias que permitem restaurar sistemas, dados e operações de uma empresa após eventos inesperados que causam interrupção ou perda de informações. O objetivo é retomar as atividades rapidamente e reduzir ao máximo os impactos negativos, seja após falhas técnicas, ataques cibernéticos ou desastres naturais.
Como criar um plano de Disaster Recovery?
Um plano de Disaster Recovery começa com mapeamento dos recursos de TI, análise de riscos e avaliação do impacto das falhas. Em seguida, definem-se RTO e RPO para cada sistema importante. O próximo passo é criar procedimentos detalhados, escolher as tecnologias de backup e recuperação, treinar as equipes e testar periodicamente todo o plano na prática. A atualização deve ser constante para acompanhar mudanças na infraestrutura e nas ameaças.
Quais são as principais etapas para recuperação?
As etapas incluem: identificação do incidente, ativação do plano, comunicação com envolvidos, restauração de dados (backups ou réplicas), verificação de integridade dos sistemas, liberação do acesso aos usuários e, por fim, análise do que pode ser melhorado para evitar novos problemas. Cada etapa deve estar documentada, com responsabilidades bem definidas.
Por que o Disaster Recovery é importante?
Ter um plano de recuperação evita perdas financeiras, protege a imagem da empresa, garante o cumprimento de contratos e de exigências legais, além de preservar a confiança de clientes e parceiros. Uma parada de sistemas pode causar prejuízos altos e, em casos graves, comprometer a sobrevivência do negócio. O plano de Disaster Recovery é a garantia de que a empresa está preparada para momentos críticos.
Quanto custa um projeto de recuperação de desastres?
O custo pode variar muito conforme o porte da empresa, a complexidade da infraestrutura, os objetivos de RTO/RPO e as soluções escolhidas (local, nuvem ou híbrida). Investir em prevenção quase sempre é mais econômico do que arcar com as consequências de um desastre real. Consultorias como a Keppel Consultoria em TI podem dimensionar o melhor plano para cada orçamento, evitando desperdícios e priorizando o que é crítico ao negócio.